(原标题:科大讯飞发布Spark-Audio-1.0-Preview全国产语音基座大模型,多语言、方言及复杂场景能力突出)
9月16日,科大讯飞发布基于全国产化算力训练的语音基座大模型Spark-Audio-1.0-Preview,支持文本和语音两个模态的输入以及文本模态的输出,可支持语音转写、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析以及复杂的音频问答等场景任务的实现,使智能语音完成从“听清”到“听懂”的跃升。
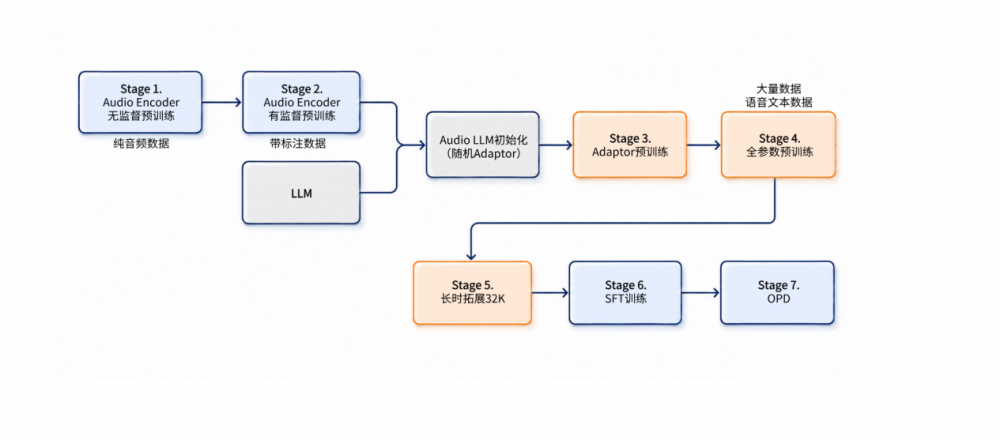
Spark-Audio-1.0-Preview采用 0.65B(Dense结构)的音频编码器,搭配30B-A3B(MoE结构)的大语言模型,使用了1300万小时音频以及大量文本数据,基于纯国产算力集群训练完成。在训练数据量仅相当于同尺寸模型Qwen3.5-omni-Flash十分之一的情况下,Spark-Audio-1.0-Preview在各项语音评测任务上效果整体相当、部分超过,尤其在偏真实应用类任务上明显领先;与尺寸更大的闭源语音基座模型效果接近。
Spark-Audio-1.0-Preview可支持99种语言及202种方言的识别。在Fleurs、KeSpeech、LibriSpeech等中英文、多语言、多方言语音识别评测任务中,Spark-Audio-1.0-Preview得分高于Gemini-3.1 Pro;Fleurs-中文测试集中,Spark-Audio-1.0-Preview取得了SOTA;面向更实际的应用场景,Spark-Audio-1.0-Preview在高噪声、小音量等复杂条件下的语音识别评测任务中也有较为明显的领先优势。
同时,Spark-Audio-1.0-Preview在通用知识、数学与代码等任务上没有出现明显降智,在指令遵循、对话、音频理解等任务上仍有进步追赶空间。
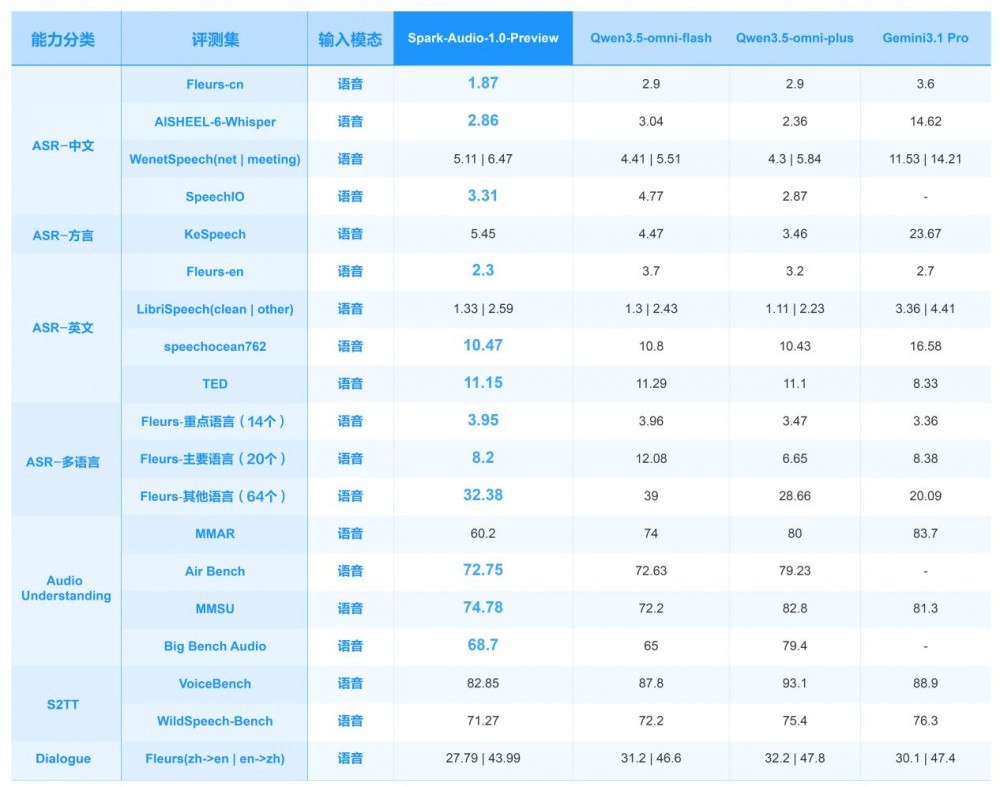
公开测试集-音频
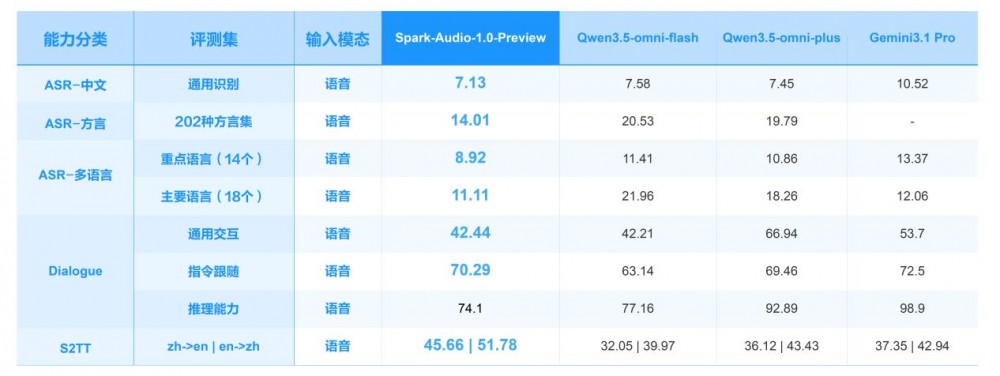
自建测试集-音频
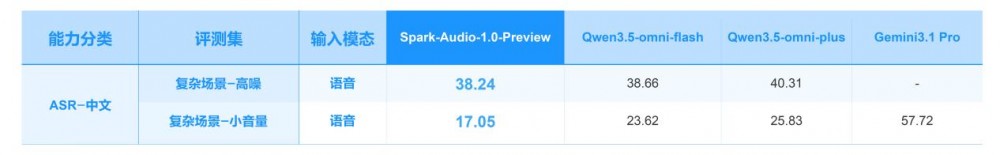
自建测试集-音频-复杂场景
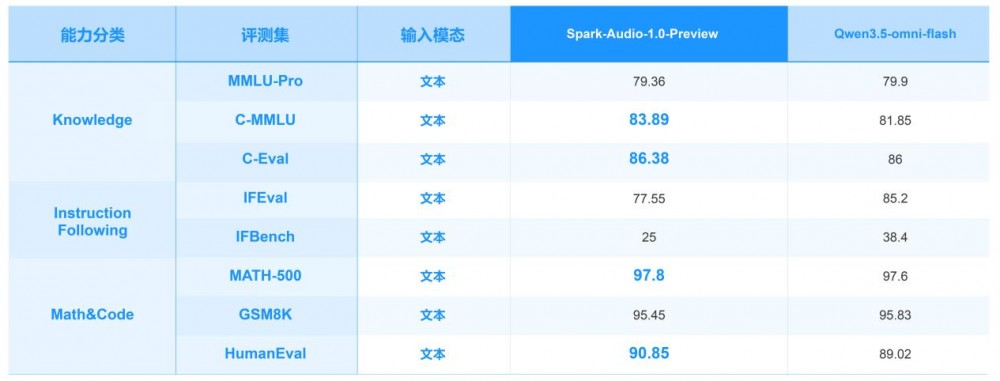
公开测试集-文本
据了解,Spark-Audio-1.0-Preview通过音频编码器预训练,逐步扩展音频编码器的表征能力;再通过预训练和后训练,提升了模型的基础能力、复杂场景泛化性以及多个任务效果,最终在99种语言、202 种方言及高噪声、小音量等复杂场景下取得优异成绩。作为业界首个基于全国产算力训练的语音基座大模型,Spark-Audio-1.0-Preview也证明了在国产算力上完全有能力训练出效果达到业界领先水平的语音基座大模型。
Spark-Audio-1.0-Preview可在实际应用场景任务上带来更好效果,如增强人机交互系统的情绪感知和多轮对话理解能力,保留语气韵律信息、带来更流畅的同传体验,提升医疗电子病历、会议转写与内容审核系统自动区分说话人、提取关键决策点及生成结构化纪要的效果。
目前,Spark-Audio-1.0-Preview已正式开放体验入口,API后续将上线讯飞开放平台;基于Spark-Audio-1.0-Preview语音基座大模型,科大讯飞还将在近期陆续展开一系列语音相关大模型的发布和升级。
本文来源:财经报道网


 首页
 微信公众号
 证券之星APP


